
The ANI-1ccx dataset: coupled-cluster labels and transfer learning with the ani-1ccx preset#
The ANI-1ccx dataset (Smith et al., Nat. Commun. 10, 2903, 2019; released in Sci. Data 7, 134, 2020) is the training set behind the ANI-1ccx potential. It is an intelligently selected ~10 % subset of the ANI-1x set, recomputed at an approximate CCSD(T)/CBS level: the CCSD(T)*/CBS composite scheme (DLPNO-CCSD(T) plus MP2/HF basis-set extrapolation), ~50× cheaper than full CCSD(T)/CBS for an aspirin-size molecule. Two things matter here:
Coupled-cluster energies, no forces. CCSD(T)*/CBS is the “gold standard” target; only energies were computed (~500 k of them).
Transfer learning. The published ANI-1ccx model is the ANI-1x architecture, pre-trained on the ~5 M DFT energies+forces of ANI-1x and then fine-tuned on the ~500 k coupled-cluster energies.
Same one-line hub as every other dataset, and since ANI-1ccx lives inside the
same ani1x-release.h5 file as ANI-1x (a conformation “is in” ANI-1ccx when
its ccsd(t)_cbs.energy was computed), the 5.6 GB download and cache are
shared with load_dataset("ani1x"):
from xnn.common.data import load_dataset
cc = load_dataset("ani1ccx", split="train")   # CCSD(T)*/CBS energies, in eV
Here we load a small subset, pair every coupled-cluster conformation with its
DFT twin from ani1x, and mimic the paper’s recipe in miniature: pre-train the
ani-1ccx preset on DFT energies+forces, fine-tune on the CCSD(T)*/CBS
energies, and compare against training on the coupled-cluster data from
scratch. This completes the series ani1_dataset.ipynb →
ani1x_dataset.ipynb → this notebook.
Run with the xnn kernel.
0. Load the coupled-cluster subset, and its DFT twin#
ani1ccx returns energy-only structures. Because it is a subset of the same
release file, every one of its conformations also appears in
load_dataset("ani1x", level="wb97x_dz") with DFT energy and forces; the
coordinates are bit-identical, so we can pair the two levels of theory exactly
and look at the gap the transfer learning has to close.
import time, warnings
warnings.filterwarnings("ignore")
import numpy as np
import torch
import matplotlib.pyplot as plt

torch.set_default_dtype(torch.float64)
torch.manual_seed(0)

from xnn.common.data import load_dataset

N_MOL = 150
# coupled-cluster subset: energy-only (CCSD(T)*/CBS has no forces), eV
cc = load_dataset("ani1ccx", max_molecules=N_MOL, units="eV")["all"]
# the same molecules at the DFT level ANI-1x was trained on, with forces
dft = load_dataset("ani1x", max_molecules=N_MOL, level="wb97x_dz",
                   units="eV")["all"]
print(f"CCSD(T)*/CBS conformations: {len(cc):,}   DFT conformations: {len(dft):,}")

# pair each coupled-cluster conformation with its DFT twin (identical coords)
by_pos = {s["pos"].tobytes(): s for s in dft}
pairs = [(c, by_pos[c["pos"].tobytes()]) for c in cc]
assert len(pairs) == len(cc)          # ANI-1ccx is a strict subset of ANI-1x

dE = np.array([(c["energy"] - d["energy"]) / len(c["atomic_numbers"])
               for c, d in pairs])
print(f"E_CC - E_DFT per atom: {dE.mean():.3f} +- {dE.std():.3f} eV")
print(f"keys per CC structure: {sorted(cc[0])}     # no forces")

plt.figure(figsize=(5.2, 3.4))
plt.hist(dE * 1e3, bins=60)
plt.xlabel(r"$E_{\mathrm{CCSD(T)*/CBS}} - E_{\mathrm{DFT}}$ per atom (meV)")
plt.ylabel("count"); plt.title("what transfer learning has to relearn")
plt.tight_layout(); plt.show()
CCSD(T)*/CBS conformations: 2,456   DFT conformations: 81,119
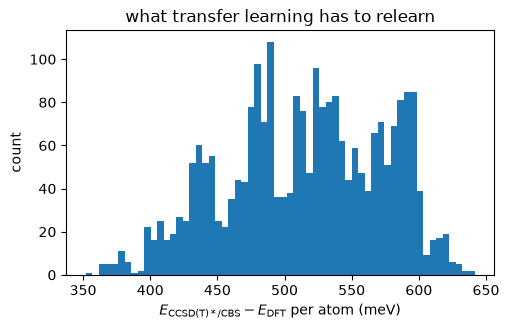
E_CC - E_DFT per atom: 0.515 +- 0.058 eV
keys per CC structure: ['atomic_numbers', 'energy', 'pos']     # no forces
1. Self atomic energies and splits#
The constant ~0.5 eV/atom offset between the two levels of theory is exactly
what per-element self atomic energies absorb, so we fit one set per level,
following the paper’s linear-fitting procedure (its SI), which published separate
DFT and CCSD(T)*/CBS parameters (the ones behind ANI.ani1x() and
ANI.ani1ccx()), and hand them to the model as atomic_energies. What is left for the fine-tuning to learn is the
conformation-dependent part of the CC-DFT difference (the ~60 meV/atom
spread above). We split the paired conformations 90/10; the coupled-cluster
test conformations are held out of both training stages.
SPECIES = [1, 6, 7, 8]

def fit_sae(structs):
    counts = np.array([[np.sum(s["atomic_numbers"] == z) for z in SPECIES]
                       for s in structs], float)
    E = np.array([s["energy"] for s in structs])
    return np.linalg.lstsq(counts, E, rcond=None)[0]

rng = np.random.default_rng(0)
idx = rng.permutation(len(pairs)); ncut = int(0.9 * len(pairs))
cc_train = [pairs[i][0] for i in idx[:ncut]]
cc_test = [pairs[i][0] for i in idx[ncut:]]
test_keys = {s["pos"].tobytes() for s in cc_test}

# DFT pre-training pool: everything ani1x gave us for these molecules, minus
# the held-out coupled-cluster test conformations, subsampled for the demo
pool = [d for d in dft if d["pos"].tobytes() not in test_keys]
dft_train = [pool[i] for i in rng.permutation(len(pool))[:8000]]

sae_dft, sae_cc = fit_sae(dft_train), fit_sae(cc_train)
print("SAE DFT (eV):", {z: round(float(e), 2) for z, e in zip(SPECIES, sae_dft)})
print("SAE CC  (eV):", {z: round(float(e), 2) for z, e in zip(SPECIES, sae_cc)})
print(f"DFT pre-train {len(dft_train):,}   CC fine-tune {len(cc_train):,}   CC test {len(cc_test):,}")
SAE DFT (eV): {1: -16.42, 6: -1036.0, 7: -1490.07, 8: -2047.0}
SAE CC  (eV): {1: -16.68, 6: -1034.47, 7: -1489.3, 8: -2046.13}
DFT pre-train 8,000   CC fine-tune 2,210   CC test 246
2. Transfer learning: DFT pre-training, coupled-cluster retraining#
The ani-1ccx preset is the ANI-1x architecture (384-length AEV,
per-element widths, CELU); the two published models differ only in training
data and self energies, and ANI.ani1ccx() simply reuses ANI.ani1x() with
the coupled-cluster self energies. We follow the paper’s recipe (its Fig. 4)
in miniature:
Pre-train on DFT energies and forces (
force_weight > 0; the force labels are why the DFT stage teaches so much more per conformation);Retrain the same weights on the CCSD(T)*/CBS energies with part of each element network held fixed to avoid overfitting the smaller coupled-cluster set, and the coupled-cluster self energies swapped in. The paper’s Methods pin this down precisely: “65,280 of the 325,248 optimizable neural network parameters held constant”. Decomposing those counts against the Table-S2 architecture, 325,248 is the total weight count (biases excluded) and 65,280 is exactly the weight matrix joining hidden layers 1 and 2 of each element network, the unique layer combination that matches, and the paper’s “two fixed hidden layers”. That is what we freeze.
and, for contrast, train an identical model on the coupled-cluster energies only, the paper’s ANI-1ccx-R control.
As in the paper’s SI, every stage uses the same optimizer settings: Adam, initial learning rate 1e-3, annealed on plateau. (The paper also evaluates Δ-learning, a second network trained on the CC−DFT difference, which matches transfer learning’s accuracy but costs two evaluations.)
from xnn.common.data import AtomicDataset
from xnn.common.config import Config, ModelConfig, DataConfig, OptimConfig
from xnn.common.train import Trainer

CUTOFF, BS = 5.2, 64

def make_trainer(structs, sae, out, lr, epochs, force_weight):
    cfg = Config(
        model=ModelConfig(name="ani", cutoff=CUTOFF,
                          extra={"preset": "ani-1ccx", "species": SPECIES,
                                 "atomic_energies": sae.tolist()}),
        data=DataConfig(cutoff=CUTOFF, batch_size=BS),  # val_fraction 0.1 carves val
        optim=OptimConfig(lr=lr, epochs=epochs, energy_weight=1.0,
                          force_weight=force_weight, scheduler="plateau"),
        output_dir=f"runs/{out}",
    )
    return Trainer(cfg, AtomicDataset(structs, CUTOFF))

# stage 1: pre-train on DFT energies + forces
pre = make_trainer(dft_train, sae_dft, "ani1ccx_pretrain", 1e-3, 60, 10.0)
print(f"parameters: {sum(p.numel() for p in pre.module.parameters()):,}  device {pre.device}")
t0 = time.time(); pre.fit()
print(f"pre-trained on DFT in {time.time()-t0:.0f}s")

# stage 2: retrain on CCSD(T)*/CBS energies -- transplant everything except
# the self-energy buffer, which switches from the DFT to the CC linear fit
tune = make_trainer(cc_train, sae_cc, "ani1ccx_transfer", 1e-3, 80, 0.0)
weights = {k: v for k, v in pre.module.state_dict().items()
           if "_self_energies" not in k}
tune.module.load_state_dict(weights, strict=False)
zero_shot = make_trainer(cc_train, sae_cc, "ani1ccx_zeroshot", 1e-3, 1, 0.0)
zero_shot.module.load_state_dict(tune.module.state_dict())   # pre-retrain copy

# hold constant what the paper holds constant: 65,280 of the 325,248 network
# weights -- exactly the matrix joining hidden layers 1 and 2 of each element
# network (see the markdown above for the derivation)
n_frozen = n_weights = 0
for net in tune.module.model.element_nets.nets.values():
    linears = [l for l in net if isinstance(l, torch.nn.Linear)]
    n_weights += sum(l.weight.numel() for l in linears)
    l2 = linears[1]
    l2.weight.requires_grad_(False); l2.bias.requires_grad_(False)
    n_frozen += l2.weight.numel()
print(f"held fixed: {n_frozen:,} of {n_weights:,} weights (paper: 65,280 of 325,248)")
assert (n_frozen, n_weights) == (65280, 325248)
t0 = time.time(); tune.fit()
print(f"retrained on CC in {time.time()-t0:.0f}s")

# ANI-1ccx-R control: same architecture trained on the CC energies only
ccx_r = make_trainer(cc_train, sae_cc, "ani1ccx_r", 1e-3, 140, 0.0)
t0 = time.time(); ccx_r.fit()
print(f"ANI-1ccx-R (CC only, no transfer) trained in {time.time()-t0:.0f}s")
parameters: 326,660  device cuda
epoch    0 | train loss 1.2438e+01 | val loss 4.0926e+00
epoch    1 | train loss 2.6904e+00 | val loss 2.0254e+00
epoch    2 | train loss 1.6905e+00 | val loss 1.6604e+00
epoch    3 | train loss 1.3294e+00 | val loss 1.2725e+00
epoch    4 | train loss 1.1713e+00 | val loss 1.1402e+00
epoch    5 | train loss 9.7834e-01 | val loss 1.0424e+00
epoch    6 | train loss 9.2896e-01 | val loss 1.1019e+00
epoch    7 | train loss 8.5252e-01 | val loss 9.7635e-01
epoch    8 | train loss 7.8725e-01 | val loss 9.8223e-01
epoch    9 | train loss 7.8359e-01 | val loss 9.4670e-01
epoch   10 | train loss 7.0863e-01 | val loss 8.5174e-01
epoch   11 | train loss 6.9095e-01 | val loss 8.2331e-01
epoch   12 | train loss 6.4029e-01 | val loss 7.6784e-01
epoch   13 | train loss 6.0600e-01 | val loss 7.6909e-01
epoch   14 | train loss 8.3453e-01 | val loss 1.0233e+00
epoch   15 | train loss 6.5868e-01 | val loss 7.4861e-01
epoch   16 | train loss 5.9577e-01 | val loss 7.8281e-01
epoch   17 | train loss 6.0525e-01 | val loss 7.6344e-01
epoch   18 | train loss 5.3586e-01 | val loss 6.6983e-01
epoch   19 | train loss 5.0312e-01 | val loss 7.1127e-01
epoch   20 | train loss 4.9283e-01 | val loss 6.7734e-01
epoch   21 | train loss 4.7643e-01 | val loss 6.2983e-01
epoch   22 | train loss 5.2775e-01 | val loss 6.8522e-01
epoch   23 | train loss 4.9748e-01 | val loss 7.0533e-01
epoch   24 | train loss 4.8723e-01 | val loss 8.6528e-01
epoch   25 | train loss 8.8367e-01 | val loss 1.1221e+00
epoch   26 | train loss 6.1676e-01 | val loss 7.1610e-01
epoch   27 | train loss 4.9103e-01 | val loss 6.3421e-01
epoch   28 | train loss 4.5245e-01 | val loss 6.1336e-01
epoch   29 | train loss 4.4291e-01 | val loss 6.0830e-01
epoch   30 | train loss 4.1744e-01 | val loss 5.8764e-01
epoch   31 | train loss 4.0041e-01 | val loss 5.6291e-01
epoch   32 | train loss 4.5442e-01 | val loss 6.8258e-01
epoch   33 | train loss 4.2370e-01 | val loss 5.8424e-01
epoch   34 | train loss 4.8801e-01 | val loss 7.9223e-01
epoch   35 | train loss 4.4265e-01 | val loss 7.4505e-01
epoch   36 | train loss 4.5893e-01 | val loss 6.8157e-01
epoch   37 | train loss 4.7516e-01 | val loss 7.3784e-01
epoch   38 | train loss 4.4793e-01 | val loss 6.6264e-01
epoch   39 | train loss 5.2843e-01 | val loss 6.9340e-01
epoch   40 | train loss 4.0953e-01 | val loss 5.9817e-01
epoch   41 | train loss 4.1611e-01 | val loss 6.0859e-01
epoch   42 | train loss 3.6088e-01 | val loss 5.7765e-01
epoch   43 | train loss 2.9906e-01 | val loss 5.3084e-01
epoch   44 | train loss 2.9031e-01 | val loss 5.3018e-01
epoch   45 | train loss 2.8840e-01 | val loss 5.2769e-01
epoch   46 | train loss 2.8655e-01 | val loss 5.2557e-01
epoch   47 | train loss 2.8539e-01 | val loss 5.2141e-01
epoch   48 | train loss 2.8487e-01 | val loss 5.2260e-01
epoch   49 | train loss 2.8403e-01 | val loss 5.2102e-01
epoch   50 | train loss 2.8251e-01 | val loss 5.2077e-01
epoch   51 | train loss 2.8174e-01 | val loss 5.1859e-01
epoch   52 | train loss 2.8085e-01 | val loss 5.1586e-01
epoch   53 | train loss 2.7991e-01 | val loss 5.1597e-01
epoch   54 | train loss 2.7929e-01 | val loss 5.1263e-01
epoch   55 | train loss 2.7785e-01 | val loss 5.1060e-01
epoch   56 | train loss 2.7741e-01 | val loss 5.1187e-01
epoch   57 | train loss 2.7704e-01 | val loss 5.0729e-01
epoch   58 | train loss 2.7524e-01 | val loss 5.0707e-01
epoch   59 | train loss 2.7504e-01 | val loss 5.0687e-01
pre-trained on DFT in 1541s
held fixed: 65,280 of 325,248 weights (paper: 65,280 of 325,248)
epoch    0 | train loss 4.1396e-02 | val loss 2.4672e-03
epoch    1 | train loss 2.1106e-03 | val loss 6.7884e-04
epoch    2 | train loss 6.4169e-04 | val loss 4.1016e-04
epoch    3 | train loss 4.8975e-04 | val loss 4.3289e-04
epoch    4 | train loss 3.6812e-04 | val loss 2.9128e-04
epoch    5 | train loss 2.3114e-04 | val loss 3.1363e-04
epoch    6 | train loss 2.2278e-04 | val loss 2.4599e-04
epoch    7 | train loss 1.6275e-04 | val loss 1.5223e-04
epoch    8 | train loss 1.2958e-04 | val loss 1.2849e-04
epoch    9 | train loss 1.2903e-04 | val loss 1.3009e-04
epoch   10 | train loss 1.0172e-04 | val loss 1.3479e-04
epoch   11 | train loss 9.6376e-05 | val loss 1.4116e-04
epoch   12 | train loss 9.4926e-05 | val loss 1.2027e-04
epoch   13 | train loss 7.9624e-05 | val loss 1.1960e-04
epoch   14 | train loss 7.4427e-05 | val loss 9.3855e-05
epoch   15 | train loss 6.6238e-05 | val loss 1.2157e-04
epoch   16 | train loss 6.5968e-05 | val loss 9.1179e-05
epoch   17 | train loss 7.6416e-05 | val loss 8.3015e-05
epoch   18 | train loss 6.6458e-05 | val loss 8.8245e-05
epoch   19 | train loss 5.6283e-05 | val loss 8.9250e-05
epoch   20 | train loss 5.3744e-05 | val loss 8.2295e-05
epoch   21 | train loss 4.9935e-05 | val loss 9.6941e-05
epoch   22 | train loss 5.6173e-05 | val loss 9.2812e-05
epoch   23 | train loss 5.6209e-05 | val loss 9.2173e-05
epoch   24 | train loss 5.4093e-05 | val loss 7.7516e-05
epoch   25 | train loss 4.2020e-05 | val loss 7.4890e-05
epoch   26 | train loss 4.7060e-05 | val loss 9.5024e-05
epoch   27 | train loss 4.2635e-05 | val loss 1.1198e-04
epoch   28 | train loss 4.6484e-05 | val loss 8.2886e-05
epoch   29 | train loss 4.2837e-05 | val loss 1.2594e-04
epoch   30 | train loss 4.9020e-05 | val loss 7.5948e-05
epoch   31 | train loss 3.5123e-05 | val loss 7.6224e-05
epoch   32 | train loss 3.9914e-05 | val loss 8.1843e-05
epoch   33 | train loss 4.1620e-05 | val loss 7.5390e-05
epoch   34 | train loss 3.4392e-05 | val loss 7.1726e-05
epoch   35 | train loss 3.4586e-05 | val loss 7.5376e-05
epoch   36 | train loss 5.0575e-05 | val loss 8.7403e-05
epoch   37 | train loss 3.5152e-05 | val loss 7.3908e-05
epoch   38 | train loss 3.4998e-05 | val loss 7.5889e-05
epoch   39 | train loss 5.3791e-05 | val loss 1.2229e-04
epoch   40 | train loss 5.3641e-05 | val loss 9.5575e-05
epoch   41 | train loss 3.6085e-05 | val loss 7.3422e-05
epoch   42 | train loss 4.5756e-05 | val loss 7.1118e-05
epoch   43 | train loss 5.9775e-05 | val loss 7.4973e-05
epoch   44 | train loss 5.5218e-05 | val loss 1.8896e-04
epoch   45 | train loss 6.5280e-05 | val loss 1.2788e-04
epoch   46 | train loss 7.2667e-05 | val loss 2.4871e-04
epoch   47 | train loss 6.1568e-05 | val loss 6.9086e-05
epoch   48 | train loss 3.4997e-05 | val loss 7.9301e-05
epoch   49 | train loss 4.3373e-05 | val loss 8.4304e-05
epoch   50 | train loss 3.3896e-05 | val loss 1.6841e-04
epoch   51 | train loss 4.3730e-05 | val loss 1.9728e-04
epoch   52 | train loss 6.0804e-05 | val loss 2.6287e-04
epoch   53 | train loss 6.3224e-05 | val loss 9.0502e-05
epoch   54 | train loss 3.3943e-05 | val loss 6.9562e-05
epoch   55 | train loss 3.3370e-05 | val loss 1.2347e-04
epoch   56 | train loss 3.3649e-05 | val loss 8.6434e-05
epoch   57 | train loss 5.3048e-05 | val loss 2.1232e-04
epoch   58 | train loss 8.7603e-05 | val loss 8.9468e-05
epoch   59 | train loss 2.6126e-05 | val loss 6.3830e-05
epoch   60 | train loss 1.7611e-05 | val loss 6.3757e-05
epoch   61 | train loss 1.8440e-05 | val loss 6.5321e-05
epoch   62 | train loss 1.6492e-05 | val loss 6.4164e-05
epoch   63 | train loss 1.5679e-05 | val loss 6.2918e-05
epoch   64 | train loss 1.5055e-05 | val loss 6.2641e-05
epoch   65 | train loss 1.4905e-05 | val loss 6.6041e-05
epoch   66 | train loss 1.4968e-05 | val loss 6.2770e-05
epoch   67 | train loss 1.5179e-05 | val loss 6.2778e-05
epoch   68 | train loss 1.4331e-05 | val loss 6.2790e-05
epoch   69 | train loss 1.5333e-05 | val loss 6.2793e-05
epoch   70 | train loss 1.5204e-05 | val loss 6.2361e-05
epoch   71 | train loss 1.4379e-05 | val loss 6.1594e-05
epoch   72 | train loss 1.3738e-05 | val loss 6.3994e-05
epoch   73 | train loss 1.3945e-05 | val loss 6.2149e-05
epoch   74 | train loss 1.4075e-05 | val loss 6.3445e-05
epoch   75 | train loss 1.5480e-05 | val loss 6.1768e-05
epoch   76 | train loss 1.5261e-05 | val loss 6.1049e-05
epoch   77 | train loss 1.4544e-05 | val loss 6.5583e-05
epoch   78 | train loss 1.5586e-05 | val loss 6.1454e-05
epoch   79 | train loss 1.3626e-05 | val loss 6.1328e-05
retrained on CC in 149s
epoch    0 | train loss 1.7699e-02 | val loss 1.4554e-02
epoch    1 | train loss 9.7817e-03 | val loss 4.6059e-03
epoch    2 | train loss 3.6900e-03 | val loss 3.4432e-03
epoch    3 | train loss 2.9725e-03 | val loss 6.0810e-03
epoch    4 | train loss 3.2924e-03 | val loss 2.0417e-03
epoch    5 | train loss 2.3469e-03 | val loss 2.7521e-03
epoch    6 | train loss 2.1448e-03 | val loss 1.7277e-03
epoch    7 | train loss 1.7884e-03 | val loss 1.9184e-03
epoch    8 | train loss 1.8999e-03 | val loss 1.9449e-03
epoch    9 | train loss 1.8694e-03 | val loss 1.6535e-03
epoch   10 | train loss 1.5620e-03 | val loss 3.5811e-03
epoch   11 | train loss 1.9642e-03 | val loss 1.3113e-03
epoch   12 | train loss 1.2507e-03 | val loss 1.9917e-03
epoch   13 | train loss 1.2876e-03 | val loss 1.2713e-03
epoch   14 | train loss 1.1322e-03 | val loss 1.2399e-03
epoch   15 | train loss 1.1964e-03 | val loss 2.1958e-03
epoch   16 | train loss 1.3258e-03 | val loss 1.5538e-03
epoch   17 | train loss 9.9817e-04 | val loss 1.1752e-03
epoch   18 | train loss 9.5691e-04 | val loss 1.2629e-03
epoch   19 | train loss 9.3690e-04 | val loss 1.2075e-03
epoch   20 | train loss 1.0505e-03 | val loss 1.2526e-03
epoch   21 | train loss 8.3546e-04 | val loss 1.0399e-03
epoch   22 | train loss 7.8488e-04 | val loss 9.1359e-04
epoch   23 | train loss 7.8536e-04 | val loss 1.3819e-03
epoch   24 | train loss 1.0235e-03 | val loss 9.8387e-04
epoch   25 | train loss 8.7827e-04 | val loss 1.6385e-03
epoch   26 | train loss 8.7085e-04 | val loss 9.6707e-04
epoch   27 | train loss 7.4644e-04 | val loss 1.4962e-03
epoch   28 | train loss 8.3714e-04 | val loss 9.0478e-04
epoch   29 | train loss 6.2574e-04 | val loss 8.9635e-04
epoch   30 | train loss 6.4467e-04 | val loss 1.1025e-03
epoch   31 | train loss 5.9620e-04 | val loss 1.3300e-03
epoch   32 | train loss 7.8016e-04 | val loss 1.2128e-03
epoch   33 | train loss 8.3658e-04 | val loss 9.0089e-04
epoch   34 | train loss 5.6219e-04 | val loss 9.3522e-04
epoch   35 | train loss 6.4547e-04 | val loss 1.1695e-03
epoch   36 | train loss 5.1936e-04 | val loss 9.0015e-04
epoch   37 | train loss 5.2918e-04 | val loss 1.6505e-03
epoch   38 | train loss 7.4145e-04 | val loss 1.6295e-03
epoch   39 | train loss 7.2743e-04 | val loss 8.5125e-04
epoch   40 | train loss 5.1751e-04 | val loss 8.4220e-04
epoch   41 | train loss 6.8155e-04 | val loss 9.2653e-04
epoch   42 | train loss 5.5102e-04 | val loss 8.8811e-04
epoch   43 | train loss 4.1737e-04 | val loss 1.0708e-03
epoch   44 | train loss 4.1089e-04 | val loss 1.1332e-03
epoch   45 | train loss 4.6918e-04 | val loss 9.9670e-04
epoch   46 | train loss 4.3298e-04 | val loss 8.0448e-04
epoch   47 | train loss 4.0670e-04 | val loss 7.5189e-04
epoch   48 | train loss 3.8891e-04 | val loss 7.6168e-04
epoch   49 | train loss 4.1890e-04 | val loss 6.9957e-04
epoch   50 | train loss 4.5239e-04 | val loss 8.0927e-04
epoch   51 | train loss 3.4424e-04 | val loss 7.2472e-04
epoch   52 | train loss 3.0920e-04 | val loss 6.9325e-04
epoch   53 | train loss 4.6385e-04 | val loss 8.1706e-04
epoch   54 | train loss 4.0084e-04 | val loss 8.3938e-04
epoch   55 | train loss 3.4552e-04 | val loss 7.2220e-04
epoch   56 | train loss 3.1820e-04 | val loss 7.7759e-04
epoch   57 | train loss 2.9654e-04 | val loss 9.8698e-04
epoch   58 | train loss 3.4949e-04 | val loss 1.0978e-03
epoch   59 | train loss 3.0588e-04 | val loss 7.9954e-04
epoch   60 | train loss 3.6310e-04 | val loss 7.3267e-04
epoch   61 | train loss 2.6141e-04 | val loss 7.0009e-04
epoch   62 | train loss 3.0736e-04 | val loss 8.0784e-04
epoch   63 | train loss 2.6078e-04 | val loss 7.1937e-04
epoch   64 | train loss 1.8289e-04 | val loss 6.6009e-04
epoch   65 | train loss 1.7123e-04 | val loss 6.7883e-04
epoch   66 | train loss 1.7112e-04 | val loss 6.9622e-04
epoch   67 | train loss 1.6710e-04 | val loss 6.5630e-04
epoch   68 | train loss 1.6775e-04 | val loss 6.5462e-04
epoch   69 | train loss 1.6393e-04 | val loss 6.4954e-04
epoch   70 | train loss 1.6382e-04 | val loss 6.5810e-04
epoch   71 | train loss 1.6078e-04 | val loss 6.8245e-04
epoch   72 | train loss 1.6055e-04 | val loss 6.4546e-04
epoch   73 | train loss 1.5795e-04 | val loss 6.5735e-04
epoch   74 | train loss 1.5751e-04 | val loss 6.4215e-04
epoch   75 | train loss 1.5514e-04 | val loss 6.4634e-04
epoch   76 | train loss 1.5993e-04 | val loss 6.5953e-04
epoch   77 | train loss 1.5739e-04 | val loss 6.6471e-04
epoch   78 | train loss 1.5667e-04 | val loss 6.4976e-04
epoch   79 | train loss 1.6309e-04 | val loss 6.8015e-04
epoch   80 | train loss 1.6052e-04 | val loss 6.4677e-04
epoch   81 | train loss 1.5088e-04 | val loss 6.8503e-04
epoch   82 | train loss 1.5996e-04 | val loss 6.4958e-04
epoch   83 | train loss 1.5123e-04 | val loss 6.6833e-04
epoch   84 | train loss 1.5379e-04 | val loss 6.4146e-04
epoch   85 | train loss 1.6081e-04 | val loss 6.5237e-04
epoch   86 | train loss 1.5283e-04 | val loss 6.5443e-04
epoch   87 | train loss 1.4783e-04 | val loss 6.4886e-04
epoch   88 | train loss 1.4607e-04 | val loss 6.4066e-04
epoch   89 | train loss 1.4592e-04 | val loss 6.4608e-04
epoch   90 | train loss 1.4982e-04 | val loss 6.2996e-04
epoch   91 | train loss 1.4571e-04 | val loss 6.9953e-04
epoch   92 | train loss 1.4531e-04 | val loss 6.4302e-04
epoch   93 | train loss 1.4291e-04 | val loss 6.5593e-04
epoch   94 | train loss 1.4364e-04 | val loss 6.4027e-04
epoch   95 | train loss 1.4510e-04 | val loss 6.4827e-04
epoch   96 | train loss 1.4179e-04 | val loss 6.3677e-04
epoch   97 | train loss 1.3831e-04 | val loss 6.5244e-04
epoch   98 | train loss 1.3704e-04 | val loss 6.3765e-04
epoch   99 | train loss 1.3524e-04 | val loss 6.4394e-04
epoch  100 | train loss 1.4190e-04 | val loss 6.3986e-04
epoch  101 | train loss 1.3635e-04 | val loss 6.5749e-04
epoch  102 | train loss 1.3097e-04 | val loss 6.3083e-04
epoch  103 | train loss 1.3231e-04 | val loss 6.3323e-04
epoch  104 | train loss 1.2809e-04 | val loss 6.3214e-04
epoch  105 | train loss 1.2669e-04 | val loss 6.3100e-04
epoch  106 | train loss 1.2701e-04 | val loss 6.3808e-04
epoch  107 | train loss 2.3252e-04 | val loss 6.3280e-04
epoch  108 | train loss 1.4900e-04 | val loss 6.4413e-04
epoch  109 | train loss 1.2971e-04 | val loss 6.3162e-04
epoch  110 | train loss 1.2727e-04 | val loss 6.3910e-04
epoch  111 | train loss 1.2919e-04 | val loss 6.3195e-04
epoch  112 | train loss 1.2568e-04 | val loss 6.3205e-04
epoch  113 | train loss 1.3046e-04 | val loss 6.3232e-04
epoch  114 | train loss 1.2767e-04 | val loss 6.3357e-04
epoch  115 | train loss 1.2537e-04 | val loss 6.3373e-04
epoch  116 | train loss 1.2752e-04 | val loss 6.3419e-04
epoch  117 | train loss 1.3743e-04 | val loss 6.3336e-04
epoch  118 | train loss 1.2521e-04 | val loss 6.3361e-04
epoch  119 | train loss 1.2607e-04 | val loss 6.3307e-04
epoch  120 | train loss 1.2508e-04 | val loss 6.3393e-04
epoch  121 | train loss 1.2649e-04 | val loss 6.3351e-04
epoch  122 | train loss 1.2760e-04 | val loss 6.3491e-04
epoch  123 | train loss 1.2782e-04 | val loss 6.3533e-04
epoch  124 | train loss 1.2912e-04 | val loss 6.3520e-04
epoch  125 | train loss 1.2865e-04 | val loss 6.3531e-04
epoch  126 | train loss 1.2484e-04 | val loss 6.3506e-04
epoch  127 | train loss 1.2639e-04 | val loss 6.3485e-04
epoch  128 | train loss 1.2708e-04 | val loss 6.3477e-04
epoch  129 | train loss 1.2531e-04 | val loss 6.3482e-04
epoch  130 | train loss 1.2587e-04 | val loss 6.3477e-04
epoch  131 | train loss 1.3041e-04 | val loss 6.3462e-04
epoch  132 | train loss 1.2642e-04 | val loss 6.3472e-04
epoch  133 | train loss 1.2443e-04 | val loss 6.3471e-04
epoch  134 | train loss 1.2693e-04 | val loss 6.3451e-04
epoch  135 | train loss 1.2538e-04 | val loss 6.3451e-04
epoch  136 | train loss 1.2529e-04 | val loss 6.3449e-04
epoch  137 | train loss 1.2518e-04 | val loss 6.3448e-04
epoch  138 | train loss 1.2821e-04 | val loss 6.3447e-04
epoch  139 | train loss 1.2584e-04 | val loss 6.3445e-04
ANI-1ccx-R (CC only, no transfer) trained in 223s
3. Parity against CCSD(T)*/CBS on held-out conformations#
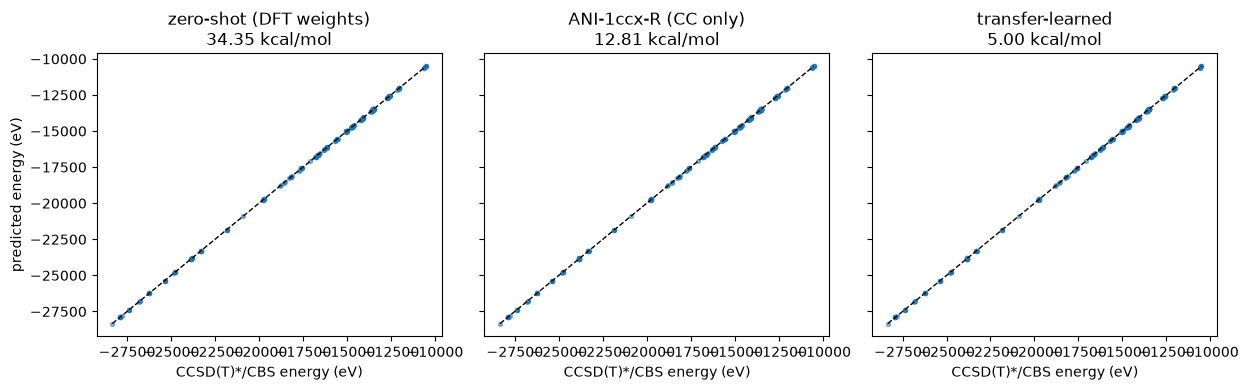
Three models, one test set of coupled-cluster energies: the DFT-pre-trained model before retraining (“zero-shot”, only the self energies adjusted, the analogue of evaluating ANI-1x against coupled-cluster references), the CC-only ANI-1ccx-R control, and the transfer-learned ANI-1ccx-style model. The paper’s point in miniature, and the same ordering as its Table 1 (ANI-1ccx 2.07 < ANI-1ccx-R 2.54 < ANI-1x 2.79 kcal/mol RMSD on GDB-10to13): the coupled-cluster data alone is too scarce, but a model that already knows the DFT potential-energy surface only needs a small correction.
from torch.utils.data import DataLoader
from xnn.common.data import collate

EV2KCAL = 23.060541945329334
test_ds = AtomicDataset(cc_test, CUTOFF)

def energies(trainer):
    model = trainer.model.eval(); device = trainer.device
    pred, ref = [], []
    for batch in DataLoader(test_ds, batch_size=64, collate_fn=collate):
        batch = batch.to(device)
        pred.append(model(batch)["energy"].detach().cpu().numpy())
        ref.append(batch.energy.cpu().numpy())
    return np.concatenate(pred), np.concatenate(ref)

results = {}
for name, tr in [("zero-shot (DFT weights)", zero_shot),
                 ("ANI-1ccx-R (CC only)", ccx_r),
                 ("transfer-learned", tune)]:
    pred, ref = energies(tr)
    rmse = np.sqrt(np.mean((pred - ref) ** 2))
    results[name] = (pred, ref, rmse)
    print(f"{name:26s} CC test energy RMSE: {rmse*1e3:7.1f} meV = {rmse*EV2KCAL:6.2f} kcal/mol")

fig, axes = plt.subplots(1, 3, figsize=(12.6, 4.0), sharex=True, sharey=True)
for ax, (name, (pred, ref, rmse)) in zip(axes, results.items()):
    ax.scatter(ref, pred, s=8, alpha=0.5)
    lim = [ref.min(), ref.max()]
    ax.plot(lim, lim, "k--", lw=1)
    ax.set_xlabel("CCSD(T)*/CBS energy (eV)")
    ax.set_title(f"{name}\n{rmse*EV2KCAL:.2f} kcal/mol")
axes[0].set_ylabel("predicted energy (eV)")
fig.tight_layout(); fig.savefig("ani1ccx_transfer.png", dpi=110); plt.show()
zero-shot (DFT weights)    CC test energy RMSE:  1489.4 meV =  34.35 kcal/mol
ANI-1ccx-R (CC only)       CC test energy RMSE:   555.6 meV =  12.81 kcal/mol
transfer-learned           CC test energy RMSE:   216.8 meV =   5.00 kcal/mol
Summary#
load_dataset("ani1ccx", ...) brings the ~500 k-conformation coupled-cluster
training set into the hub under its own name: a strict subset of the ANI-1x
release, so the 5.6 GB file is downloaded and cached once for both. Paired
with the ani-1ccx preset (ANI.ani1ccx(), the ANI-1x architecture with
coupled-cluster self energies), it reproduces the published model’s setup:
DFT pre-training on ani1x, coupled-cluster fine-tuning on ani1ccx.
The full family, side by side:
ANI-1 ( |
ANI-1x ( |
ANI-1ccx ( |
|
|---|---|---|---|
labels |
DFT energies |
DFT energies + forces |
CCSD(T)*/CBS energies |
size |
~20 M |
~5 M |
~500 k |
sampling |
dense Normal-Mode |
active learning |
active sub-sampling of ANI-1x |
preset |
|
|
|
training |
direct |
direct |
transfer learning from ANI-1x |
The relative ordering above (transfer-learned best, the CC-only ANI-1ccx-R
control worse, the DFT model worst against coupled-cluster references)
reproduces the paper’s central result (its Table 1), here at demo scale. For the pretrained ANI-1x/ANI-1ccx weights transplanted from
torchani (rather than trained here), see
examples/fidelity_checks/ani_verification.ipynb and the parity tests in
tests/test_ani.py.